マルチAgent協調におけるデータ一貫性と高信頼アーキテクチャ設計
ひとこと要約:マルチAgentシステムでデータが食い違う根本原因はモデルの賢さ不足ではなく、通信アーキテクチャに状態の分離と検証がないことにある。そのため、集中型の共有状態、検証済みのタスクグラフ、ノードごとの3層検証、納品前の突合、グレースケール評価リリースによって、安定した本番稼働が可能になる。
重要なポイント
- 500億を1200億と計算してしまうような誤りは、Agent間が自由文でポイントツーポイントに伝言していることが原因だ。下流は元の事実を得られず推測するしかなく、集約時にも誰を信じるべきか分からないため、プロンプトの修正やモデルの交換では根本的に治らない。
- データ層では集中型の共有状態を使い、強い型付け、ロール別の書き込み権限の分離、バージョン記録を加える。タスク層では、大規模モデルが生成した依存グラフをまずプログラムで検証し、そのうえでフィールドの絞り込みとツールのホワイトリストで各ノードを制約する。
- 誤りは発生源で止める。ノードは書き戻し前に契約・証拠チェーン・一貫性の3層検証を通し、失敗時はその場で再試行する(上限は一般に2回以内)。それでも通らなければ縮退分岐に進み、異常を外に漏らさない。納品前にはグローバルな事実との突合で、根拠のないデータを要確認として印を付けるか除外する。
- コアノードで誤りが出たら状態スナップショットを保存して人手の介入を求め、修正後は中断した箇所から再開できるため、全体をやり直す必要はない。非コアのタスクはタイムアウトや繰り返しのエラーで縮退させ、幹となる処理を優先して通す。
- 稼働後はTrace IDによる追跡と定量指標で、チューニングに客観的な根拠を与える。プロンプト、ツール、DAGのいずれの変更も、まず評価リグレッションとグレースケールリリースを通し、局所的な変更がチェーン全体を壊すのを防ぐ。
セクション別要約
0:35事例紹介と四つの構造的問題
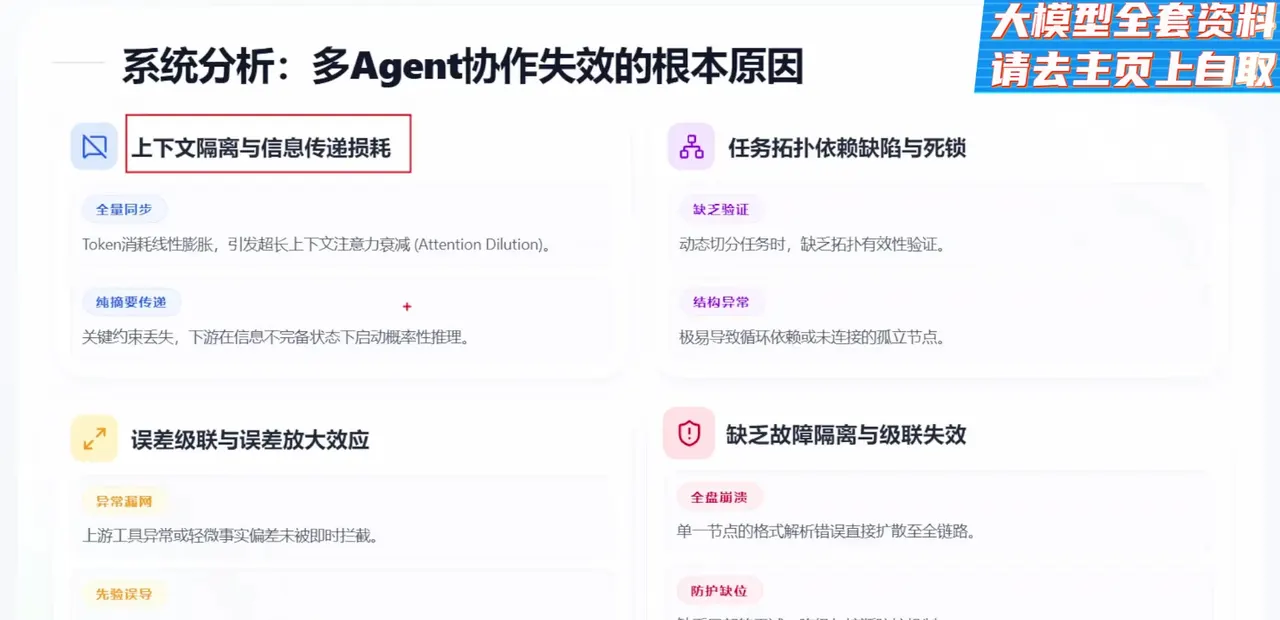
調査レポート生成を例に、4つのAgentがそれぞれ構成の計画、データ検索、計算分析、レポート執筆を担当した。その結果、検索された基準市場規模は500億だったのに、分析Agentは800億と計算し、執筆Agentの要約は1200億と書いた。症結はモデルの賢さの有無ではなく、通信アーキテクチャに状態の分離と検証のゲートがないことにある。チェーンを分解すると4つの構造的問題が見える。コンテキスト伝達のジレンマ、トポロジー検証のない動的タスク分割によるデッドロックの起きやすさ、上流の誤りが雪だるま式に拡散すること、そして局所的な耐障害性とフォールバックによる縮退の欠如である。
▶ ここから見る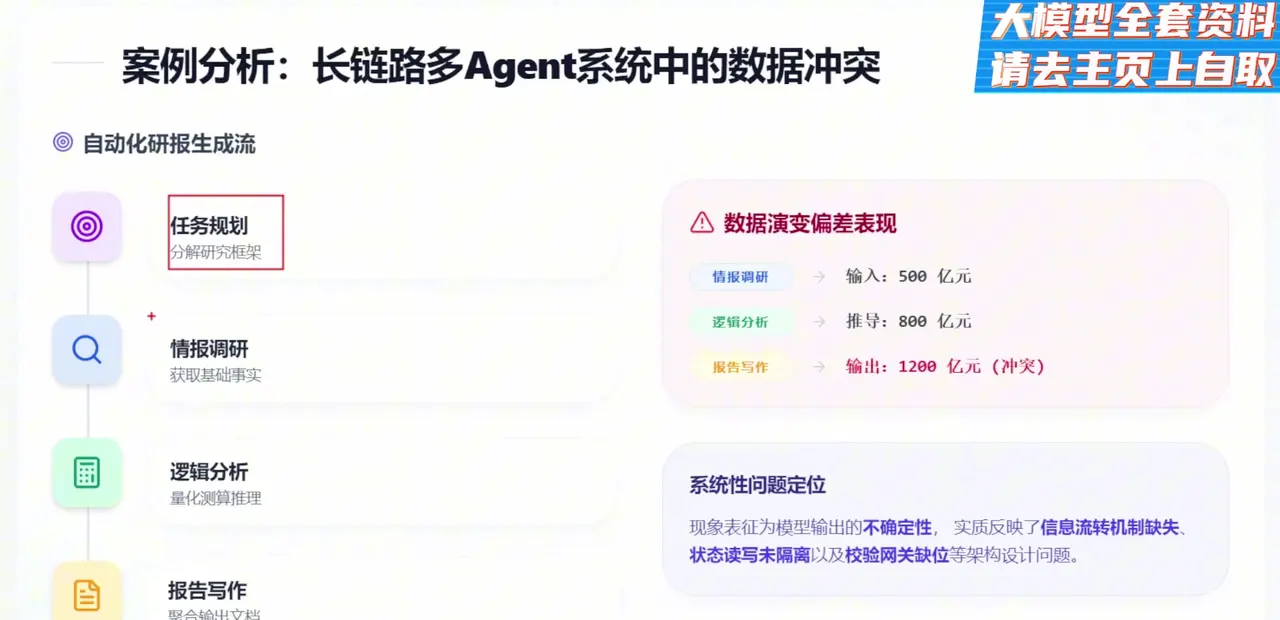
3:35集中型共有状態と三つの規範
解決策は、Agentが自由文でポイントツーポイントに伝言するのをやめ、集中型の共有状態空間で読み書きを一元化することだ。そこでは3つの規範を守る。Pydanticの強い型付けで各業務フィールドを制約すること、ロールごとに書き込み権限を分離すること(調査は元の事実のみ、分析は自分の分析フィールドのみ書ける)、そして読み書きのたびにバージョン番号と書き込みノードを自動記録し、問題を発生源まで遡れるようにすることである。
▶ ここから見る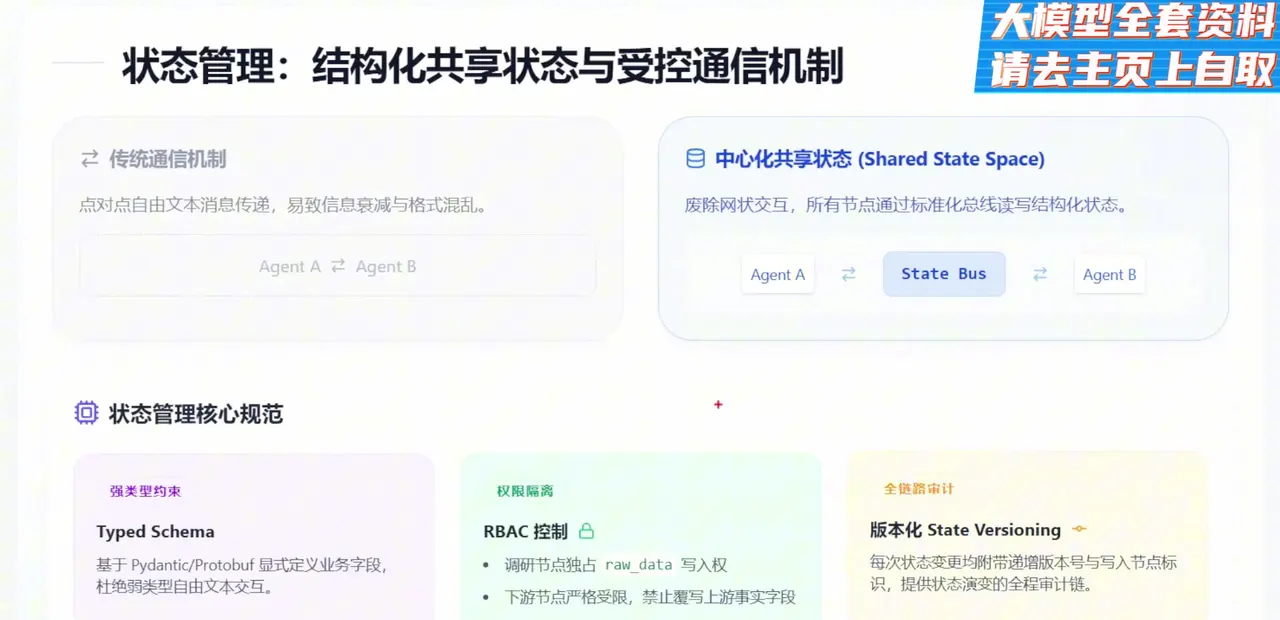
5:05タスク依存グラフの検証と実行時の防護
大規模モデルが生成したタスク依存グラフは、そのまま実行してはならない。まずプログラムによる検証器で、有向非巡回の検出(循環依存とデッドロックの排除)、連結性のチェック(各サブタスクに入力元と出力先があること)、意味的に重複するタスクの統合を行う。実行段階ではノードの挙動も制約する。分析ノードに必要なフィールドだけを渡してトークンを節約し、ツールのホワイトリストで呼び出せる範囲を制限する(例えば調査ノードには検索のみを開放し、プログラム実行権限は与えない)。越権によるデータ汚染を避けるためである。
▶ ここから見る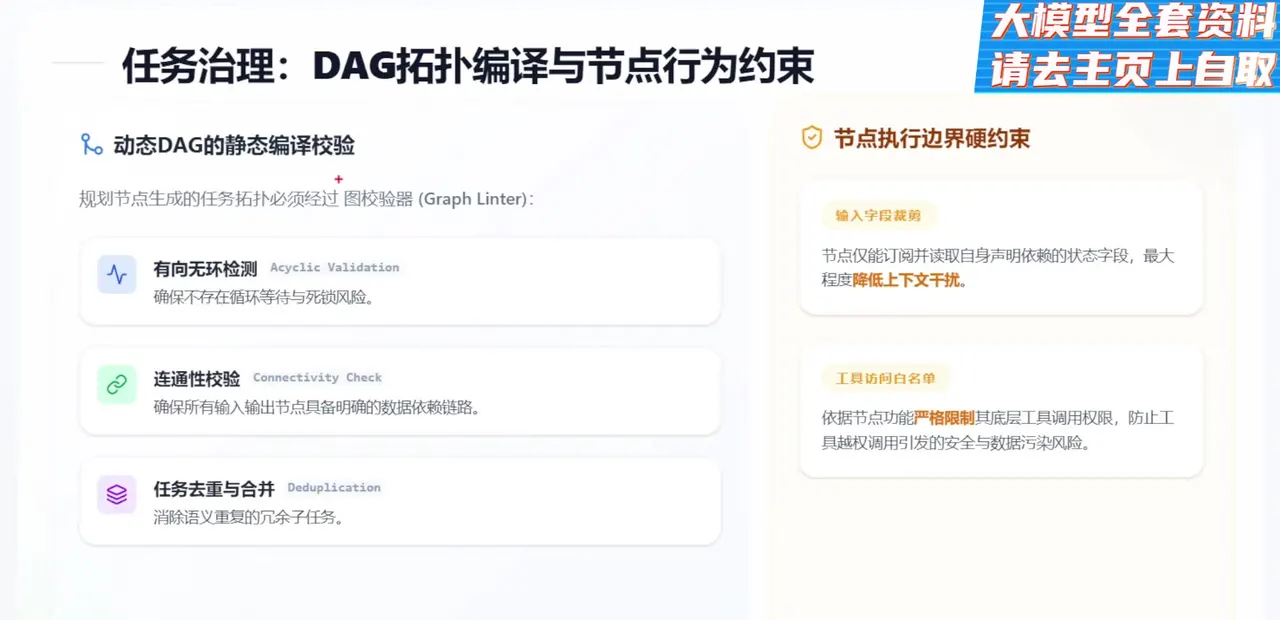
6:15ノードの3層検証と再試行・縮退
ノードが共有状態へ書き戻す前に、3層の検証を通す。契約検証(形式が既定の構造に合っているか。JSONの解析失敗はその場で遮断)、証拠チェーンの照合(重要なデータが検索内容に裏付けを見つけられなければ異常と判定)、一貫性の照合(導いた結論が共有状態の既存の事実と論理的に衝突しないか)である。いずれかの層で不合格なら、エラー原因を診断情報にまとめて返し、ノードに局所的な再試行をさせる。上限は一般に2回以内だ。それでも通らなければ縮退分岐に進み、例えば既定値を入れたり非コアの手順を飛ばしたりして、異常を単一ノード内に封じ込め、下流に影響を与えない。
▶ ここから見る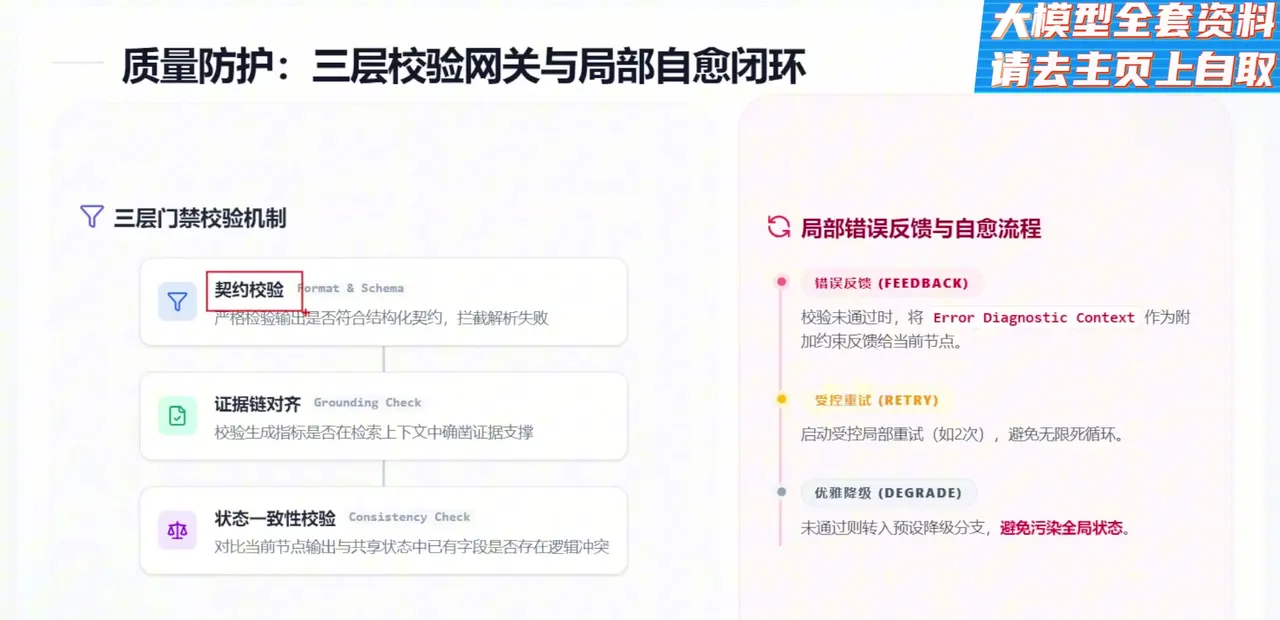
7:35グローバルな事実突合と遮断型の耐障害性
レポートの納品前に、まずグローバルな事実突合を行う。原稿中のすべてのコアデータと重要な結論を共有状態と逆方向に照合し、根拠が見つからないものは要確認として印を付けるか、直接除外する。同時に各ノードにタイムアウト時間と再試行の上限を設定する。非コアのタスクはタイムアウトや繰り返しのエラーで縮退させ、幹となる処理を優先して通す。コアノードで誤りが出てシステムが自力で処理できない場合は、状態スナップショットを保存して人手の介入を求め、確認または修正の後に続きから実行でき、プロセス全体を最初からやり直す必要はない。最後に、システムを長期的に保守するには可観測性が欠かせないと指摘する。
▶ ここから見る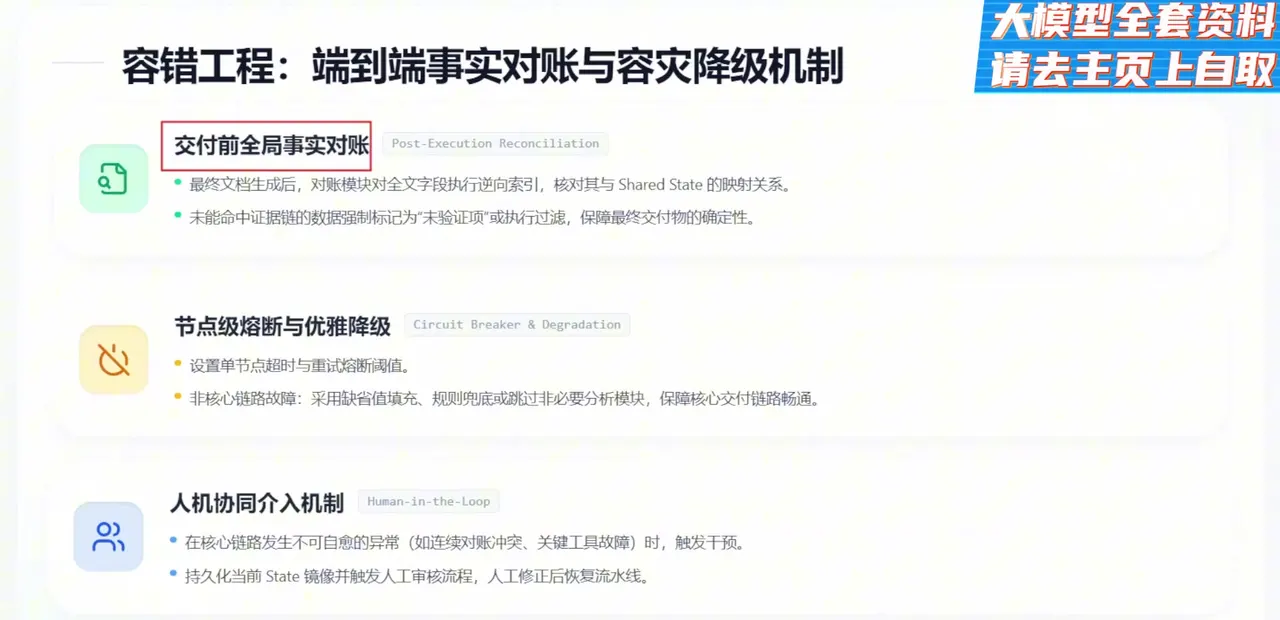
8:55可観測性のトレースと定量指標
タスクが起動されるたびに、グローバルに一意なTrace IDが生成され、各Agentの操作(ツール呼び出し、状態の読み書き)がSpanとして記録されて、明確なタイムライン表示になる。これをもとに定量指標を作る。データ一貫性達成率は検証ゲートが異常を何回止めたかを見るもの、各ノードのトークン消費比率は無駄な消費を洗い出すもの、チェーンの実行時間分布は性能のボトルネックを特定するものだ。これにより、チューニングは勘による当てずっぽうではなく、客観的なデータに基づく。
▶ ここから見る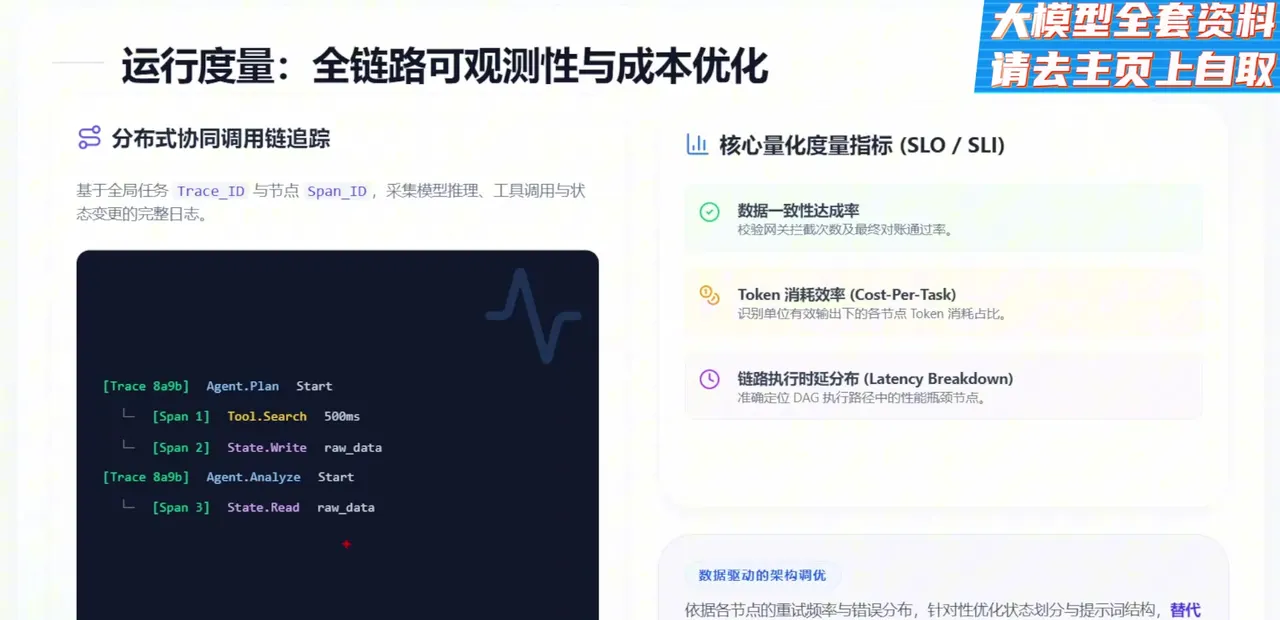
10:15評価リグレッションとグレースケールリリースの流れ
リリース前に標準化した評価データセットを作る。典型的なタスク、長いコンテキストでのマルチホップ推論、わざと難しくした異常入力を含め、リリースのたびにリグレッションテストを自動実行して、一貫性が基準を満たすか、タスク完了率が下がっていないか、一タスク当たりの平均呼び出しコストが制御不能になっていないかを見る。プロンプト、ツール編成、DAGの変更は、そのまま本番に出してはならない。まず静的コンパイル検証を行い、次に基準データセットでリプレイして劣化がないことを確認する。本番投入はグレースケールリリースで行い、まず少量の実トラフィックで観察し、指標が安定してから段階的に全量へ広げる。
▶ ここから見る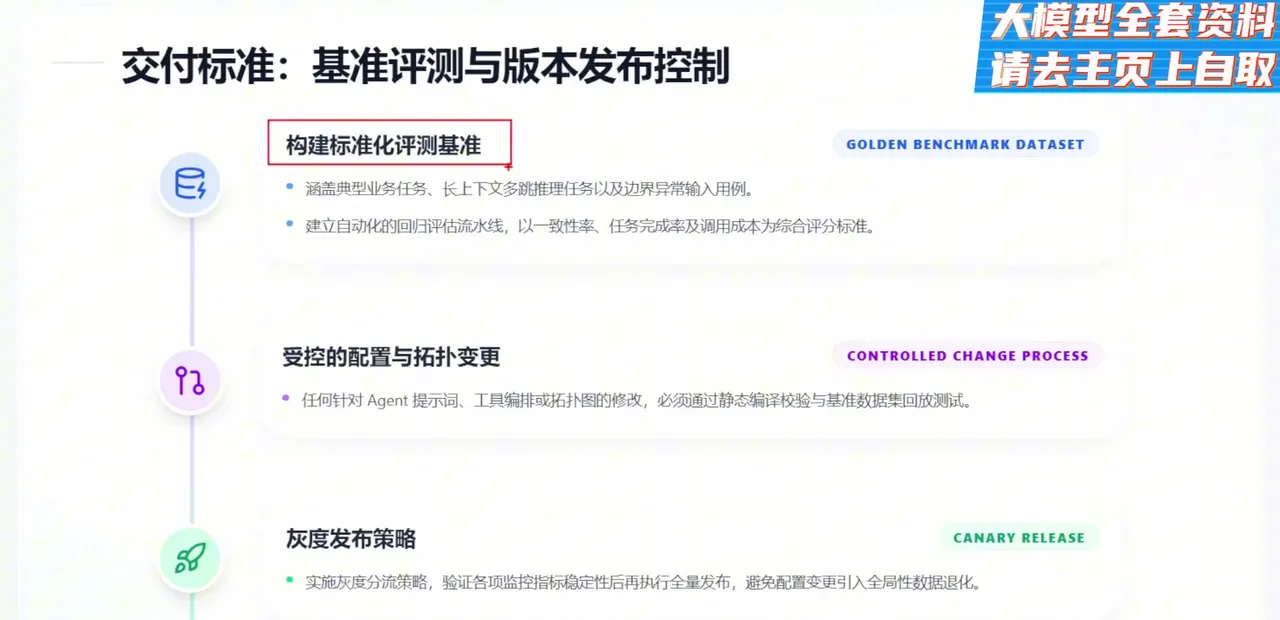
11:15マルチエージェント工学実践のまとめ
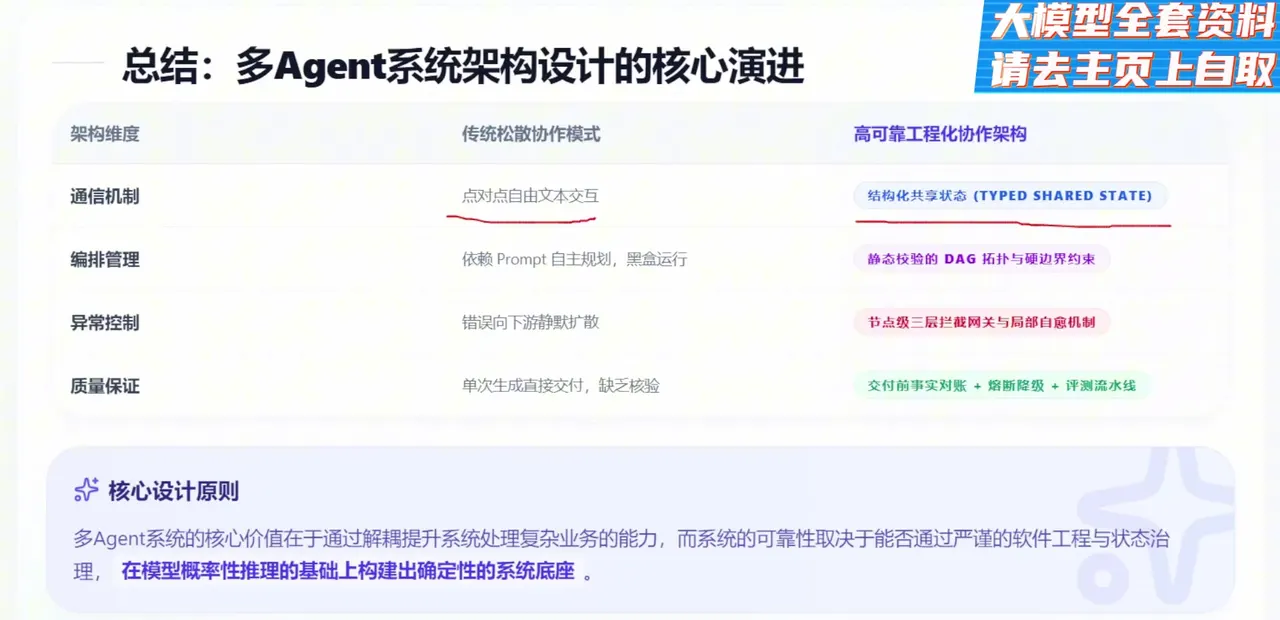
まとめて対比する。通信の仕組みは、自由文の伝言から構造化された共有状態へ変わり、強い型付けと権限の分離が加わる。タスクの編成は、すべてをモデルの自律的な計画に任せたブラックボックス運用から、静的検証を経たDAGへ変わり、ノードの入力とツールの境界が定められる。異常の制御は、誤りが下流へ拡散し続ける状態から、重要ノードでの3層検証とその場での再試行・縮退により問題を局所に封じ込める形へ変わる。納品品質には、グローバルな事実突合、遮断による縮退、自動化された評価パイプラインが加わる。マルチAgentの価値は、タスクを分離して複雑な業務を処理することにあり、安定して実運用できるかは、ソフトウェア工学と状態管理の手法で、モデル推論の上に確実で信頼できるシステム基盤を築けるかにかかっている。
▶ ここから見る